출간 예정 가제
피지컬 AI로 배우는 RoboCo · QUAD-02 · DECIDE
장애물 앞에서 다음 행동을 고른다
장애물 앞에서 멈춘 뒤, 규칙 또는 학습된 정책으로 방향을 골라 우회하고 다시 걷게 한다.
완성된 로봇을 먼저 실행하고, 움직임을 관찰하고, 구조를 이해한 뒤 값과 동작을 바꿔 결과를 비교합니다. 실패하면 원인을 찾아 한 조건만 고쳐 미션을 완성합니다.
4족 로봇은 어떻게 행동을 결정하는가?
이 책에서 해낼 것
대표 미션 — 장애물 앞에서 멈춘 뒤, 규칙 또는 학습된 정책으로 방향을 골라 우회하고 다시 걷게 한다.
이 책의 사용법
- 먼저 사람이 만든 규칙으로 로봇을 움직인다.
- Q-Learning은 수식 암기가 아니라 시행착오의 결과를 관찰하는 실험으로 시작한다.
- 학습 과정과 평가 실행을 반드시 나누어 기록한다.
대표 로봇: 센서·상태·행동 선택이 더해진 4족 로봇
QUAD-01의 4족 로봇에 거리 센서와 관성 센서를 연결하고, 상태 기계(State Machine)로 멈춤·회피·복구를 고르게 합니다. 사람이 만든 규칙과 Q-Learning으로 배운 정책을 같은 조건에서 비교합니다.
5 PART · 25 CHAPTER
- 완성 로봇 실행
- 움직임 관찰
- 구조 이해
- 값과 동작 변경
- 결과 비교
- 실패 원인 확인
- 미션 완성
- PART 1 · EXPERIENCE직접 움직여 보기
장애물을 보고 행동을 고르는 첫 실행 — 자율 주행 모드 첫 실행 · 장애물을 본 순간 멈추게 하기 · 로봇은 어느 쪽으로 피해야 할까 외 CH01~05
- PART 2 · UNDERSTAND움직임의 구조 이해
센서값이 판단과 행동이 되는 구조 — 센서 데이터에서 로봇 상태로 · 앞 권의 보행 기능 이어 쓰기 · 로봇 상태를 설계하기 외 CH06~10
- PART 3 · CONTROL값과 동작 제어
규칙으로 자율 행동 만들기 — 장애물을 알아보는 거리 기준 바꾸기 · 좌우 거리로 회피 방향 정하기 · 피하고 다시 걷는 동작 순서 만들기 외 CH11~15
- PART 4 · EXPERIMENT조건 변경과 결과 비교
로봇이 시행착오로 길을 배우게 하기 — 사람이 정한 규칙의 결과 먼저 보기 · 로봇이 시행착오로 길을 배우는 한 번의 시도 · 좋은 선택에는 왜 보상을 줄까 외 CH16~20
- PART 5 · PROJECT미션 완성 및 개선
AI 자율 4족 프로젝트 — 복합 장애물과 검증 기준 정하기 · 규칙 기반 자율행동 반복 검증 · Q-Learning 학습 과정 보기 외 CH21~25
시리즈에서 QUAD-02의 위치
QUAD-02는 4족 로봇을 확장하는 QUAD 트랙의 책입니다. 대응 개념은 CORE-02에서 이어집니다.
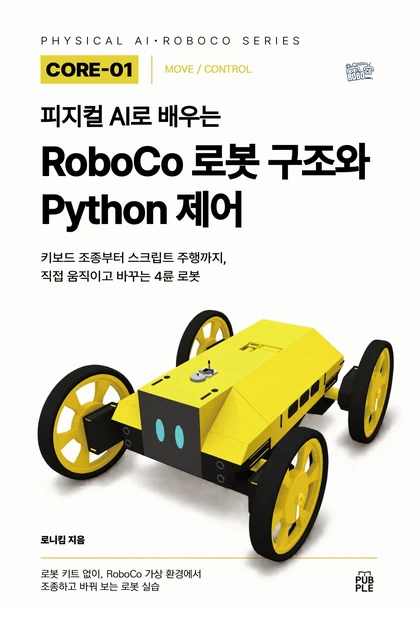
지금 만날 수 있는 시리즈 첫 권
피지컬 AI로 배우는 RoboCo 로봇 구조와 Python 제어
키보드 조종부터 스크립트 주행까지, 직접 움직이고 바꾸는 4륜 로봇 — 입력·제어·움직임·관찰의 흐름은 시리즈 모든 권의 바탕이 됩니다.
도서 정보
| 도서명 | 피지컬 AI로 배우는 4족 로봇 자율보행과 AI 가제 |
|---|---|
| 시리즈 | 피지컬 AI로 배우는 RoboCo · QUAD-02 (DECIDE) |
| 저자 | 로니킴 |
| 실습 환경 | RoboCo (Steam) |
| 출간 상태 | 출간 예정 출간 일정은 이 페이지에서 안내합니다. |